一张图做歌词 MV
旋转唱片、滚动歌词与可视化
对口型 MV 要生成好几段视频,耗时又耗算力。如果只是想给一首歌配一个好看、能上传的画面,其实一张图就够了:人物在一边,另一边一张旋转的黑胶唱片,歌词从下往上滚,底部再加一条跟着音乐跳动的波形。这篇记录我们改了四版才定下来的过程。
一、最终效果
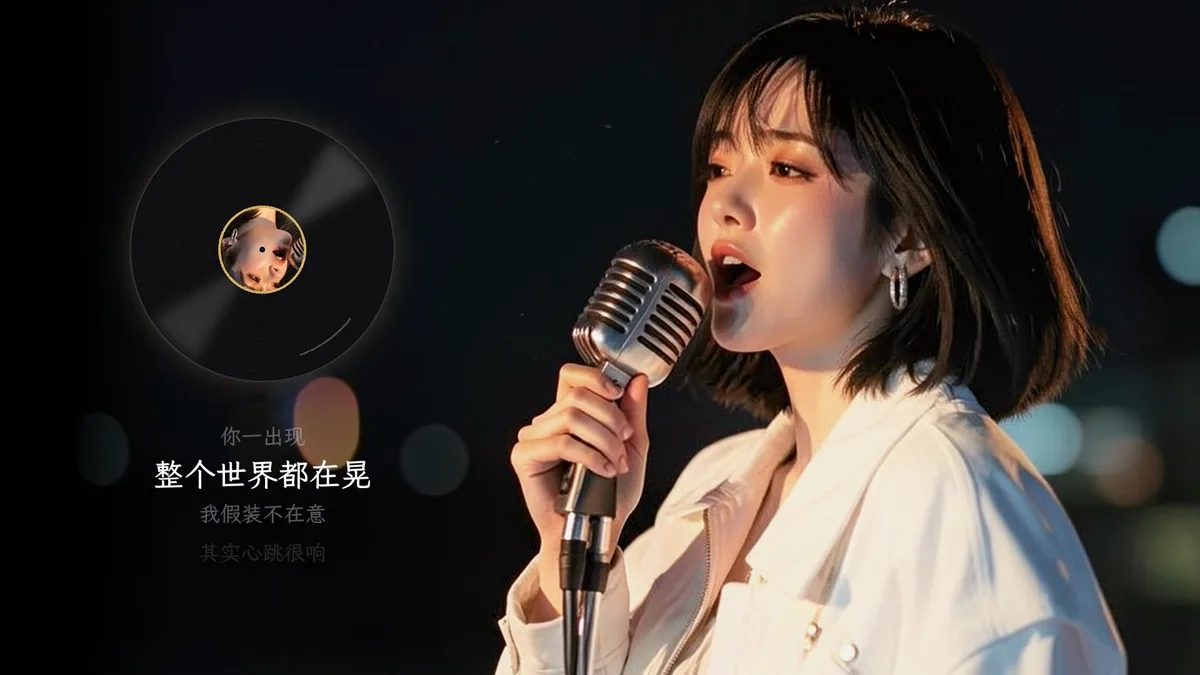
画面分三层:底层是人物图;中层是代码画的黑胶唱片和滚动歌词,整段渲染成一个 23 秒的视频;上层在剪辑台里叠加——上下电影黑边、底部波形可视化、唱片上的环形可视化、右下角台标。音乐和原来的 MV 完全一样。
二、第一版:在图里加一台留声机(被否)
最开始的想法是在原图里用改图模型加一台复古留声机。图是加上了,但留声机是静止的,和「音乐在播放」的感觉不搭,而且整张图变得很满。后来改成:唱片不放在图里,用代码单独画一张会旋转的黑胶。
代码画唱片其实很简单:一个黑色圆盘、几十圈深浅交替的细纹、中心一张圆形标签(用歌手脸部裁一块贴上去)、一圈金色描边,再加一道静止的高光——唱片转、高光不转,旋转感就出来了。转速按真实黑胶的 33⅓ 转/分钟。
三、第二版:抠像把人物放一边(被否)
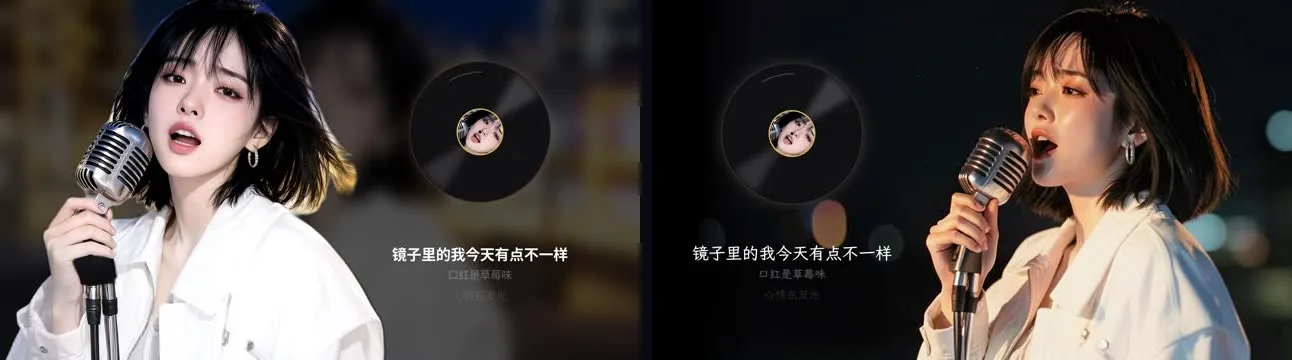
第二个要求是「背景变暗、人物在一边、另一边是唱片」。我们先用开源抠像模型把人物抠出来,背景压暗、模糊,人物放在左边。结果是:头发边缘一圈硬边,肩膀和背景交界处有残留,越看越假。
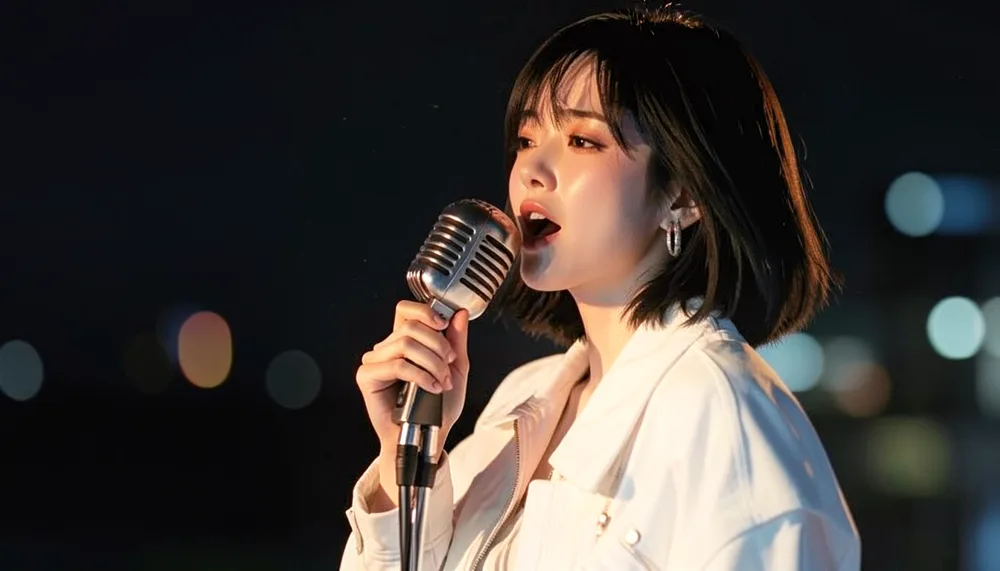
我们又试了「不抠像、用柔和的大范围遮罩只把人物周围提亮」,好一些,但人物的原始构图在画面中间,挪到一侧就得裁掉一部分。最后的解决办法是放弃抠像,直接用改图模型重新生成一张构图合适的图:保持人物、发型、夹克和麦克风不变,只改构图为「人物在画面右侧三分之一,左侧大面积暗色留白」。一次生成,25 秒。
四、滚动歌词:时间轴和一句识别错误
歌词的时间点来自本地语音识别(Qwen3-ASR):把歌送进去,拿到每句的开始时间。滚动规则是:当前句在固定位置、放大、纯白;上一句和下一句变小、变灰;切换时用 0.45 秒的缓动往上滚。
问题出在第 8 句。识别结果是「嘴角上扬 眨眨眼」,听起来也挺像,我们就用了。直到后来把 Musicful 曲库里的原始歌词导出来做网站页面,才发现原词是「three two one 别眨眼」——中英混唱,识别模型把英文数数听成了中文。改好后重新渲染了整段视频。
| 字幕来源 | 优点 | 风险 |
|---|---|---|
| 语音识别 | 快,自带时间轴 | 中英混唱、同音词、歌手咬字会听错 |
| 原始歌词 | 字一定对 | 没有时间轴 |
| 识别 + 原歌词对照 | 时间轴准、字也对 | 要多花几分钟 |
所以我们现在的规矩是:识别只用来拿时间轴,文字一律以原始歌词为准。原始歌词在你写歌时就有,不需要额外的工作。
五、照着做的步骤清单
- 准备一首歌和一张人物图。图的构图要留出一侧空白;没有就用改图模型重新生成,提示词写「保持人物不变,只改构图:人物在画面右侧三分之一,左侧大面积暗色留白」。
- 拿到歌词时间轴:用语音识别拿每句的开始时间,再把文字换成原始歌词。
- 渲染背景视频:底图 + 旋转唱片 + 滚动歌词,输出和歌曲等长的 1080p 视频(我们用 Python 逐帧画,23 秒约 690 帧)。人物可以加一个很慢的放大(23 秒内放大 4%),画面会有呼吸感。
- 进剪辑台:视频放 V1 并静音,歌曲放音频轨;加电影黑边、底部波形可视化、唱片位置的环形可视化、台标。
- 检查三个时间点:开头第一句、中间副歌、最后一句,确认歌词滚动和演唱对得上。
- 导出前保存工程文件,再导出 MP4。
整个流程里最花时间的是第 1 步的反复——我们在构图上改了四版:图里加留声机、抠像放左边、柔和遮罩、最后重新生成。如果一开始就按「人物在一侧、另一侧留白」去生成图,整支歌词 MV 会快很多。
六、字体、配色和可视化
- 字体:默认黑体太硬,换成了手写感的霞鹜文楷(开源 OFL 字体,可商用),更贴情歌的气质。
- 位置:唱片和歌词放在同一侧、上下排列,人的视线从唱片自然往下落到歌词。
- 可视化:唱片上叠了一层白色细环形频谱,低透明度,看起来像唱片纹路在随音乐跳动;底部是细的语音波形,幅度调小,不抢画面。
- 黑边:上下加 2.35:1 电影黑边,注意歌词和唱片都要放在黑边以内的安全区。