RTX 4060 Ti 8GB 本地生图实测
FLUX.2 与 Juggernaut XL 怎么选
这不是参数表搬运,而是同一台 RTX 4060 Ti 8GB 电脑上的完整测试记录。目标很简单:网站以后如果提供免费本地生图,哪个模型能跑、哪个模型更清晰、哪个模型适合真人,先用实际结果说话。
一、测试环境与判断标准
测试电脑使用 NVIDIA RTX 4060 Ti 8GB、约 64GB 内存。为了避免模型一次性塞满显存,运行时启用 CPU offload。我们没有只看“能不能出图”,而是同时记录四件事:首次下载占用、实际生成耗时、峰值显存,以及人眼能直接看出的结构问题。
第一轮选择 FLUX.2 klein 4B,是因为它体积相对可控、四步即可生成,并能覆盖文生图和编辑。第二轮选择 Juggernaut XL v9,是因为它基于 SDXL,单文件权重约 6.6GB,目标明确指向写实人像。
二、FLUX.2 klein 4B:场景快,人像不够稳
FLUX.2 场景测试采用 768×432、4 steps。实际生成约 18 秒,夜景、冷暖色、人物、小舟、竹篙、石阶和灯笼关系都能一次交代清楚。对于概念图、建筑、环境和镜头气氛,它的速度与中文理解都令人满意。
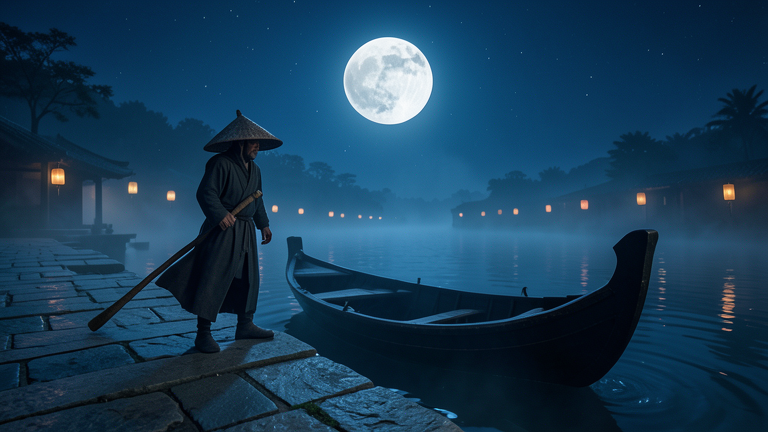
问题出现在人物近景。第一次真人化编辑把毛孔、皮肤凹凸和锐化推得过重;第二次即使限制痘印、油光和夸张纹理,脸颊仍出现合成质感。结论不是“模型不能画人”,而是它不适合作为我们网站的高质量写实人像主模型。
三、Juggernaut XL v9:写实提升,但不是身份一致性方案
Juggernaut 首测采用 768×1024、30 steps、CFG 5、model CPU offload。生成耗时 50.51 秒,PyTorch 记录峰值显存 2.83GB。皮肤、头发、眼睛、服装和影棚光线明显比 FLUX.2 自然。
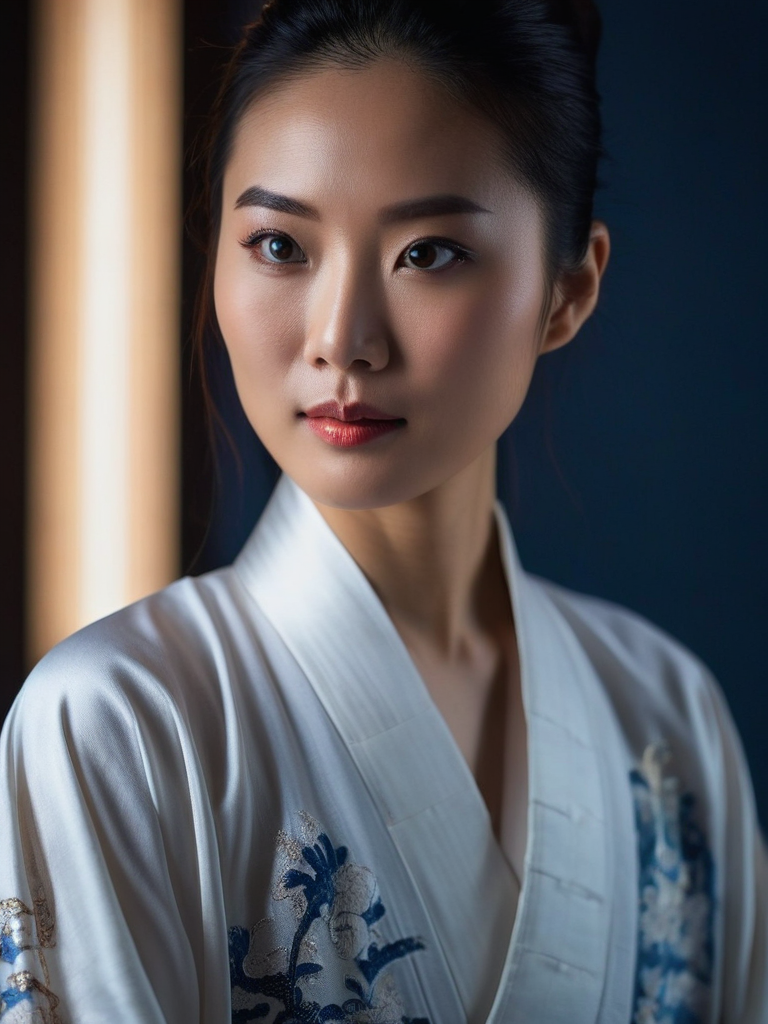
随后我们把分辨率提高到 1024×1536,峰值显存约 3.76GB,8GB 显卡仍能稳定完成。不过,超近景会放大模型缺陷:左右眼形状、视线、眉形和鼻翼只要有一点偏差,整张脸就会显得不自然。因此“图片清晰”不能等同于“脸部正确”。
四、实测对比
| 项目 | FLUX.2 klein 4B | Juggernaut XL v9 |
|---|---|---|
| 主要优势 | 四步生成快,场景、气氛和中文提示理解好 | 写实皮肤、头发、服装材质更自然 |
| 本机生成耗时 | 768×432 约18秒 | 768×1024 约50秒 |
| 本地占用 | 官方仓库组件较多,完整缓存明显更大 | 单文件权重与配置约6.6GB |
| 人物问题 | 容易出现塑料皮肤和夸张纹理 | 整体更自然,但眼睛、鼻翼仍可能轻微变形 |
| 适合用途 | 场景概念图、构图、快速草案 | 本地写实人像基础图 |
五、我们的最终选择
如果你只有 8GB 显存,建议先从 768×1024 开始。需要更大图片时,再提高到 1024×1536,并限制总像素、开启 CPU offload。不要只追求分辨率;先把构图和五官做对,再进行低强度高清修复,成功率更高。
六、显存峰值是怎么量出来的
很多评测只写“这张卡能跑”,却不写是怎么量的。显存这件事最容易骗人的地方在于:加载完模型时的占用,和真正采样到一半时的峰值,可能差 1.5GB 以上。只看加载完那一眼,你会得出“完全够用”的结论,然后在第 12 步 采样时崩掉。
我们用的是最笨但最可靠的办法:跑生成的同时,另开一个终端每秒记录一次显存。
nvidia-smi --query-gpu=memory.used,memory.total --format=csv -l 1 把这一行挂在旁边跑,生成结束后取整段里的最大值,那才是这套参数真实的显存需求。
要注意三件事。第一,Windows 桌面本身会吃掉 0.6~1.2GB,浏览器开着 YouTube 还能再吃 1GB,所以“8GB 显卡”实际能给模型的往往只有 6.2~6.8GB。第二,峰值通常出现在两个位置——UNet/DiT 采样的中段,以及最后 VAE 解码那一下;VAE 解码的峰值和输出分辨率是平方关系,1024×1024 解码占用大约是 512×512 的四倍。第三,同一套参数第二次跑会比第一次省一点,因为部分权重还在缓存里,所以判断“能不能跑”要以冷启动的第一次为准。
我们给自己定的判断线是:峰值必须比可用显存低 800MB 以上。刚好卡在边缘的配置,在你换一张参考图、多加一个 LoRA、或者顺手打开一个视频窗口的时候,就会翻车。留出这 800MB,本质上是买一个“今天还能正常干活”的保险。
七、两个模型的失败样本长什么样
模型对比最有价值的部分不是精选图,而是失败图。精选图人人都能挑出好看的,但决定你日常工作顺不顺的,是它失败的时候烂成什么样、以及烂得规不规律。
FLUX.2 klein 4B 的典型失败是“对了,但不是那个人”:构图、光线、氛围都相当稳,脸也没崩,就是和上一张不是同一个人。它的失败是平滑的、可接受的,你不会觉得画面坏了,只会觉得选角换了。所以它适合做场景、空镜、氛围板、背景层——这些地方没人追究“是不是同一个人”。
Juggernaut XL v9 的典型失败更尖锐:皮肤质感和写实度明显更好,但一旦进入超近景,五官比例容易出现细微的错位——瞳孔不等大、鼻翼一边高一边低、嘴角一侧被拉长。这类错误在缩略图上看不出来,一放到 1080p 时间线上就特别刺眼。它的失败是局部的、突然的。
- 如果你要的是“十张里挑一张能用”,两者都可以,Juggernaut 上限更高。
- 如果你要的是“十张里有八张能直接用”,FLUX.2 klein 的下限更稳。
- 如果你要的是“同一个人出现在十张里”,这两条路都不是答案——那是参考图 + 一致性流程要解决的问题,不是选模型能解决的。
把这三种需求分开,是我们后来少走很多弯路的原因。之前我们一直想找“一个模型全都解决”,实际上是把三个不同的问题混在一起问了。
八、如果你的显卡不是 8GB
这篇测试是在 8GB 上做的,但结论可以按显存等级平移。下面这张表是我们实际调下来的起点参数,不是理论值。
- 6GB:只跑 4B 级别的小模型,起始分辨率降到 768×768,关掉所有 LoRA,必要时开 VAE 分块解码。SDXL 系(Juggernaut 属于这一支)在 6GB 上要开 offload 才能跑,慢一倍以上,不建议作为主力。
- 8GB:本文的主场。1024×1024 原生生成、单 LoRA、不开 offload,是舒适区;上到 1280 或加第二个 LoRA 就要开始盯峰值了。
- 12GB:可以稳跑 1024 原生 + 两三个 LoRA,或者 1536 的长边生成。这一档开始,显存不再是主要瓶颈,速度才是。
- 16GB 及以上:可以考虑更大的底模和更高的原生分辨率,放大也可以一次过而不用分块。
有一点要提醒:显存决定“能不能跑”,算力决定“跑多久”,这两件事经常被混为一谈。同样 8GB,4060 Ti 和几年前的旧卡都能加载同一个模型,但出图时间可能差三倍。你看到别人说“我 8G 也能跑”,请顺便问一句一张图多少秒——能跑但一张要四分钟,在实际项目里等于不能用。
显存不够时的排错顺序,我们单独写了一篇:8GB 显存本地生图怎么避免爆显存。