参考图为什么仍会变脸
人物多视角一致性实测与解决流程
上传参考图并不等于模型已经“认识这个人”。基础图生图更擅长保留版式、衣服和整体气质,却可能把每个角度都画成不同的相似人物。下面是一次真实多视角设定图测试,以及我们据此调整的制作流程。
一、这次测试怎么做
输入是一张白色无缝影棚中的女性多视角设定参考:左侧大头像,右侧依次排列正面、侧面和背面全身。测试目标不是重新设计人物,而是检查模型能否同时保住五类信息:脸部身份、发型、红色短上衣、白色短裤、高跟鞋以及四视图版式。
参数为 1024×576、30 steps、CFG 5、Seed 20260910、Strength 0.55,并开启 model CPU offload。实际去噪16步,生成约29.5秒,峰值显存约2.12GB。
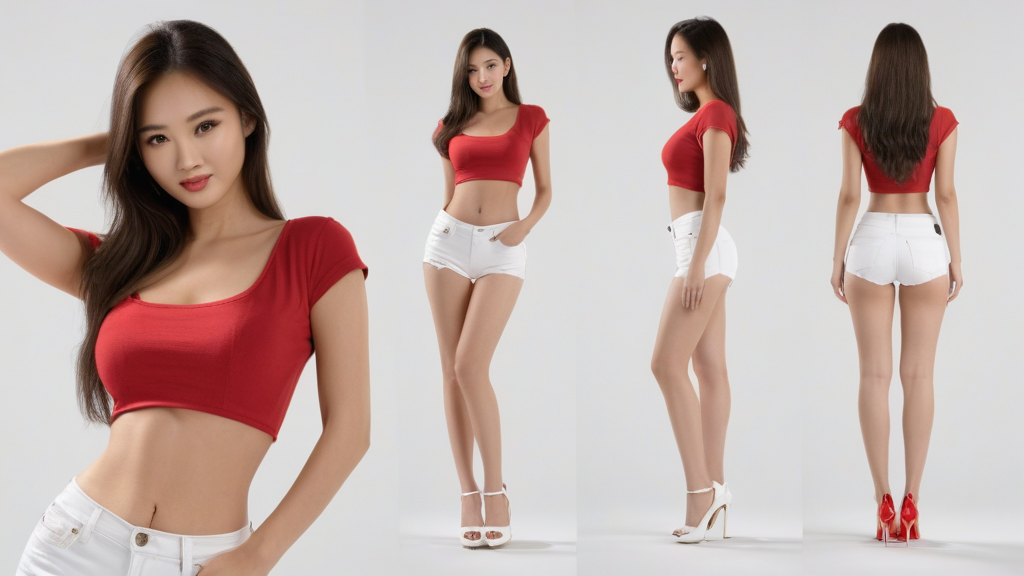
二、保住了什么,又丢了什么
保住:版式与大色块
白色影棚、左侧头像、正侧背全身的布局稳定;红上衣和白短裤也基本一致。
部分保住:发型与身材
长发和整体比例接近参考,但侧脸、后脑勺和发梢会被模型重新解释。
没有保住:严格身份
正面与侧面的五官更像同一类型,而不是同一个真人在不同角度的照片。
发生漂移:局部物件
背面高跟鞋颜色变红,说明小面积、远离视觉中心的细节最容易被模型改写。
三、为什么“图生图”仍会变脸
Strength 不是“像不像”的单独旋钮。强度太低,模型只会贴着原图做轻微变化,姿势和画面难以改变;强度太高,模型拥有更多重绘空间,身份、服装和小配件就容易漂移。基础 SDXL 图生图依赖整张画面的视觉特征,并没有专门的人脸身份编码器。
多视角设定又比单张头像更难:一张图里同时出现多个尺度不同的脸,模型会把它们当成多个视觉区域,而不是自动理解成“同一个人转身”。因此,仅靠一句“人物完全一致”无法解决身份问题。
四、可复用的一致性流程
- 先做身份母版:选择正脸、光线均匀、无遮挡的头肩照。不要一开始就用复杂姿势或多人合照。
- 再做角色设定:固定发型、服装色块、饰品和身材描述,建立一份永远不改的角色锚点。
- 接身份控制:使用 InstantID、IP-Adapter FaceID 或同类身份适配器;只有基础图生图时,把结果标记为“风格参考”,不要宣称严格同一人。
- 每个角度单独复核:比较眼距、鼻翼、唇形、下颌线、耳朵和发际线。缩略图看不出的错,放大后会非常明显。
- 局部细节单独修:鞋子、耳环、手指、衣服扣子用遮罩修复,避免为了改一个小物件把整张脸重新生成。
- 保留参数与种子:记录模型版本、Seed、分辨率、CFG、Strength和参考图,失败时才能找到是哪一个变量造成漂移。
五、上线功能应该怎样向用户说明
如果网站提供“人物一致性”功能,界面不应该只放一个上传框然后承诺“绝对一致”。更准确的产品分级是:基础参考图=保留风格与构图;身份锁定=尽量保持同一人物;局部修复=处理五官和配件细节。把能力边界写清楚,用户才知道哪一步出了问题。
六、参考图本身的质量要求
很多“参考图没用”的情况,问题不在流程,在那张图本身。参考图是整条一致性链路的源头,源头模糊,后面再规范也补不回来。
- 脸部要占足够比例。一张全身照里脸只有一百多个像素,模型能提取的身份信息极少。参考图应该以头肩为主,脸部尽量清晰。
- 光线要平。参考图上的强烈阴影会被当成人物特征学走,结果是每一镜都带着那道阴影。定妆照用均匀光。
- 表情要中性。大笑的参考图会让模型把“笑”当成这个人的固有属性,后面想让他严肃就很难。
- 不要有遮挡。手挡着下巴、头发盖住半张脸的参考图,模型只能猜被挡住的部分,而每次猜的结果都不一样。
- 分辨率够但不必过大。脸部区域有 512 像素以上通常就够了,更大不会带来更好的一致性。
一个很容易被忽略的点:参考图最好是 AI 自己生成的。用真人照片作参考,除了肖像权的问题,模型对“照片风格”和“生成风格”的处理也不完全一致,反而更容易出现风格断层。
七、多张参考图怎么组合
单张参考图的天花板很明显:正脸对了侧脸不对,近景对了远景不对。多参考图是提升上限的方式,但组合方式有讲究。
- 三视图(正 / 侧 / 四分之三)是最基础的一组。它解决的是“不同角度对不上”这个最常见的问题。
- 加一张表情图。如果片子里人物有明显情绪变化,补一张不同表情的参考,能避免情绪一变就换脸。
- 加一张全身图。用来锁体型和服装,中远景镜头主要靠它。
- 不要塞进互相矛盾的图。发型不同、年龄看起来不同的两张图放在一起,模型会取一个折中值,结果哪一张都不像。这是多参考图最常见的翻车原因。
所以多参考图的前提是这几张图本身要先互相一致。先花时间把三视图做到彼此吻合,再拿去用;直接把几张“大概像”的图丢进去,效果往往还不如单张。
八、把流程写成一份清单
一致性最终是纪律问题,而纪律靠清单落地,不靠记忆。下面这份是我们实际在用的,每开一个新项目就复制一份。
- 确定人物设定文字稿(外观 + 声线),存成 txt。
- 生成候选定妆照,挑一张,之后不再更换。
- 基于定妆照做三视图,检查三张之间是否互相吻合,不吻合就重做。
- 写出固定的文字锚点短语,和图片放在同一个文件夹。
- 每一镜的提示词都从这份锚点复制,不要手打。
- 出图后按角色分文件夹归档,文件名带镜号。
- 全部镜头完成后,把所有出现该角色的画面并排看一遍——这一步经常能发现单独看时注意不到的漂移。
第七步最容易被跳过,也最有价值。一镜一镜看的时候大脑会自动接受“差不多”,只有排在一起才看得出第 3 镜和第 9 镜其实不是一个人。