ComfyUI 开箱实测
8G 显卡出图、出视频,还跑通了音画同步
ComfyUI 是一个免费开源的 AI 创作软件,装在自己电脑上,用自己的显卡出图、出视频。很多人被它满屏的方块和连线劝退。2026 年 11 月 15 日,我们当了一回完全没用过的小白:从官网下载开始,装好桌面版,用一张 8G 显存的显卡依次跑了出图、图生视频和音画同步三个模型。这篇把每一步的截图、模型大小、用时和踩过的坑都记下来,数字都是当天实际跑出来的。
一、先看结果:三个模型的用时
测试电脑是 64G 内存、8G 显存的 N 卡。三个模型都用 ComfyUI 自带的模板,没有装任何第三方插件。
| 模型 | 做什么 | 模型下载大小 | 设置 | 用时 |
|---|---|---|---|---|
| Z-Image Turbo | 文生图 | 19.27GB(3 个文件) | 1024×1024,8 步 | 31.08 秒(含第一次加载模型) |
| Z-Image Turbo | 文生图 | 同上 | 1920×1088,8 步 | 38.87、40.65、46.09 秒(三次) |
| Wan 2.2 14B | 图生视频,无声音 | 35.42GB(6 个文件) | 832×480,5 秒,开加速 | 560.04 秒,约 9 分 20 秒 |
| MiniMax H3 | 图生视频,带对白和声音 | 约 40GB(5 个文件) | 16:9,0.3 百万像素,5 秒,开加速 | 153 秒 |
| MiniMax H3 | 同上 | 同上 | 16:9,调高百万像素(成片 1216×672),5 秒 | 能跑通,用时没有记下来 |
下面这段就是 8G 显卡用 MiniMax H3 跑出来的成片:人物开口说话,嘴型和声音是一起生成的,没有后期配音。
二、安装:四个要注意的选项
桌面版从官网 comfy.org/download 下载,有 Windows、Mac 和 Linux 三个版本。不要从第三方下载站下。安装本身是一路「下一步」,但有四个选项选错了会很麻烦:
- 安装位置不要放 C 盘。软件本身只要 5G 左右,但模型很大:我们这一天下了三套模型,加起来将近 95GB。安装时把目录改到别的盘,至少留 100GB。
- 「云端」还是「本地」,选本地。云端是官方的付费服务,有免费试用;本地是用自己的显卡跑,不花积分。电脑配置很低的可以考虑云端。
- 中国镜像按所在地选。软件检测到系统语言是中文时,会问要不要启用中国镜像。人在国内选「启用镜像」,下载会快很多;人在国外选「暂不」。
- 入门工作流先跳过。安装向导最后会推荐几个工作流,视频类的一个就要 41 到 53GB,8G 显卡不一定带得动。我们选了「跳过并安装」,进软件以后再按自己的显卡挑。
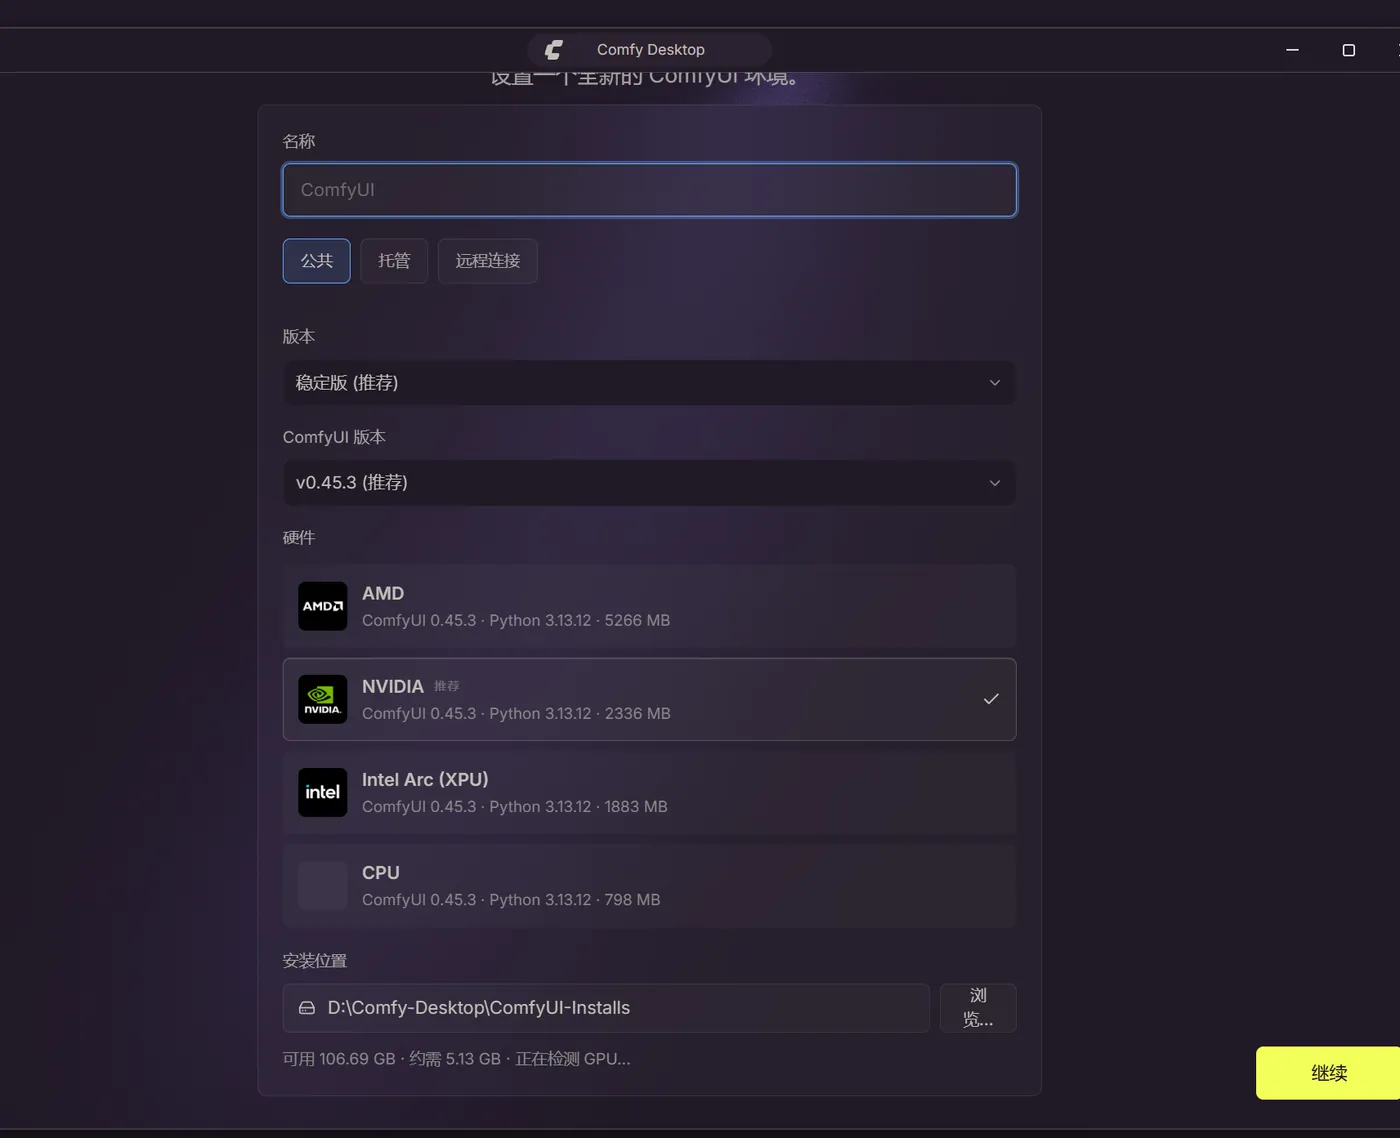
装好以后界面如果是英文,在设置里把语言改成中文即可。模板库里的模型名和节点参数名仍然是英文,比如 seed(种子)、steps(步数)、duration(时长)、turbo(加速),认识这几个词就够用了。
三、第一张图:Z-Image Turbo
不要自己连线。点左边的「模板」→「图像」,选「Z-Image-Turbo:文生图」,一整条线已经连好了。
刚打开时中间的方块有一圈红框,右上角提示「发现 3 个问题」。这不是报错,意思是缺 3 个模型文件:
| 文件 | 作用 | 大小 |
|---|---|---|
| z_image_turbo_bf16.safetensors | 出图的主模型 | 11.46GB |
| qwen_3_4b.safetensors | 读懂提示词的文字模型 | 7.49GB |
| ae.safetensors | 把结果解码成图片 | 319.8MB |
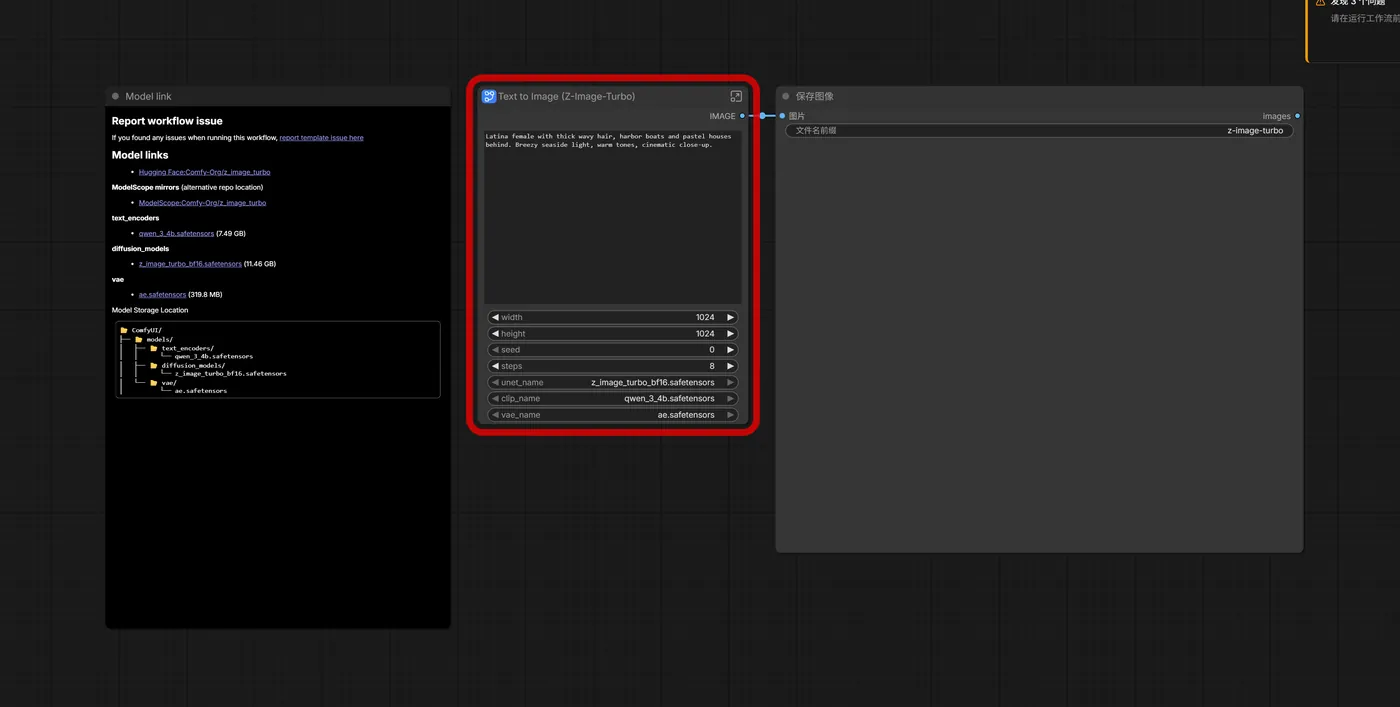
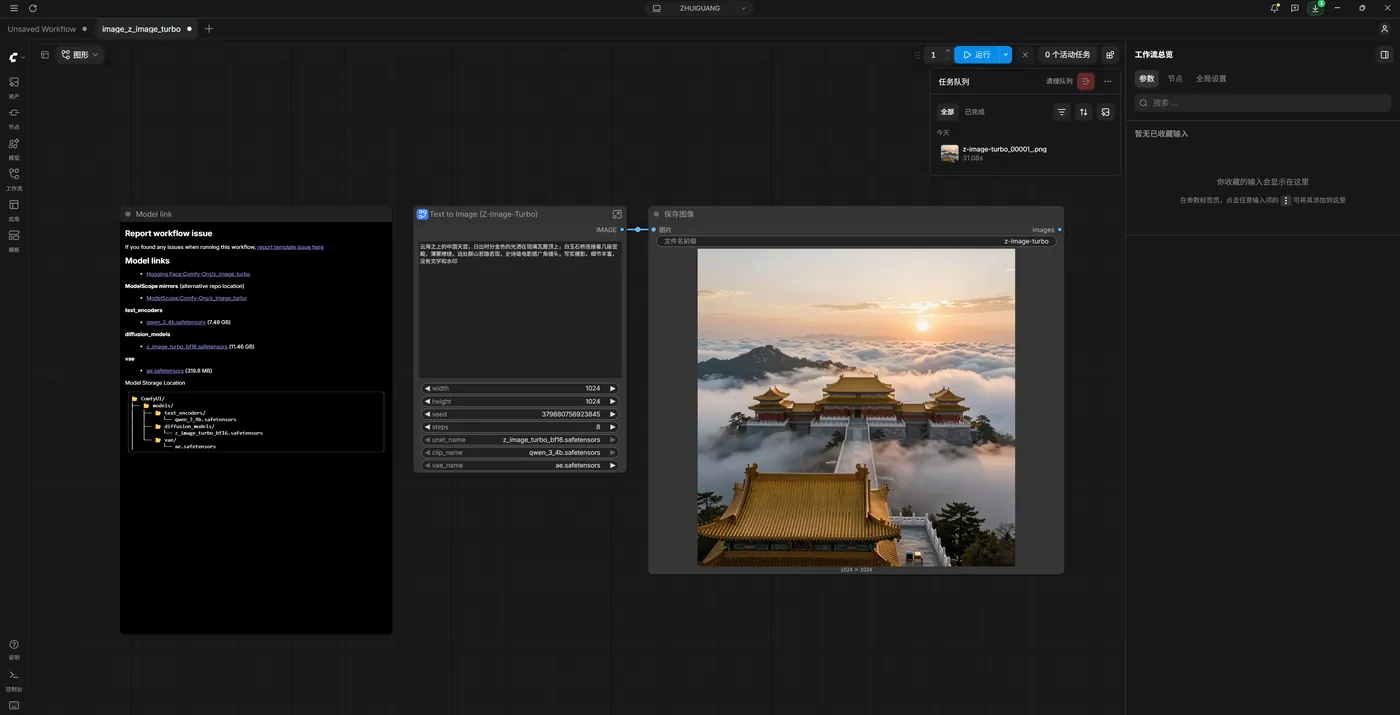
点「查看详情」→「全部下载」,一共 19.27GB。下载完点一下刷新,红框消失,就可以用了。然后把方块里的英文提示词删掉,换成自己的。Z-Image 能直接读中文,我们用的第一条是:
第二条换成人像,同时把尺寸直接改成 1920×1088:
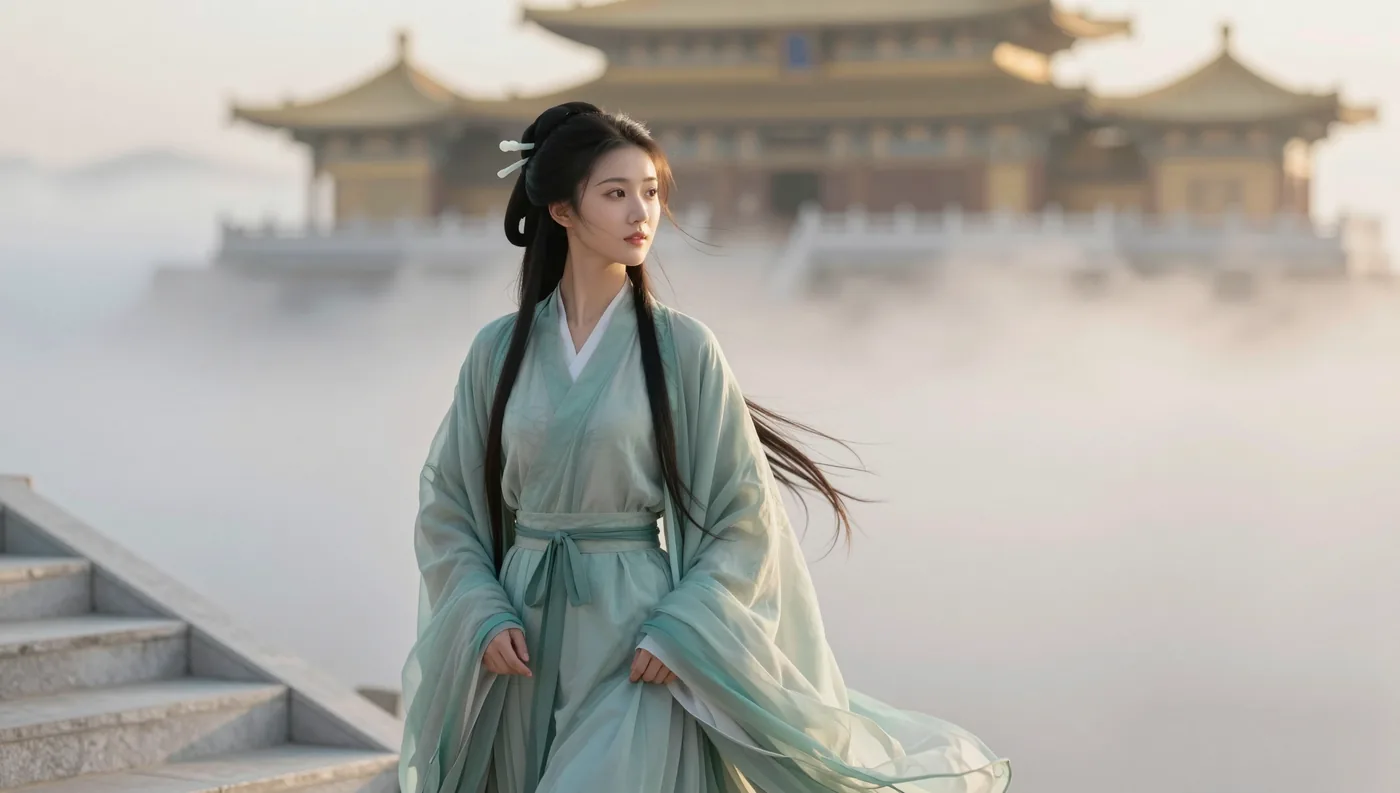
全高清尺寸在 8G 显卡上也只用了 39 到 46 秒。提示词不动、连点三次运行,三张图的人和构图都不一样,因为模板默认每次自动换一个 seed。seed 可以理解成这张图的编号:提示词相同、seed 不同,图就不同;想复现某一张,就把它的 seed 记下来固定住。
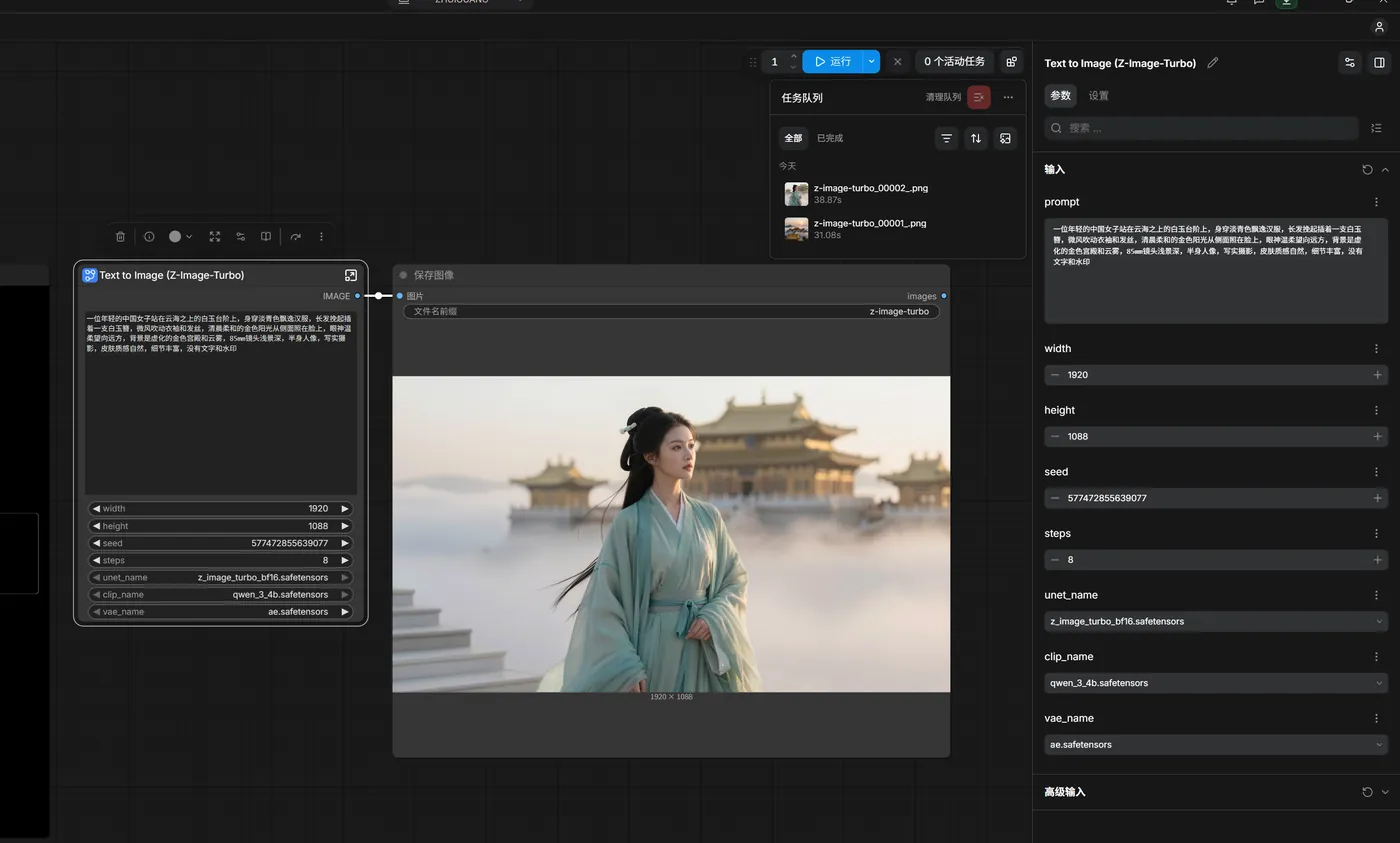
生成的图都在左边工具栏的「资产」里,点下载按钮就能存到电脑上。
四、图生视频:Wan 2.2 14B
接着让这张图动起来。在「模板」→「视频」里选「Wan 2.2 14B 图生视频」,这次提示「发现 6 个问题」,同样是缺模型,全部下载要 35.42GB:高噪、低噪两个主模型各 13.31GB,两个 4 步加速 LoRA 各 1.14GB,文字模型 6.27GB,VAE 242MB。
模板左下角有一张官方的速度表,测试用的是 24G 显存的 RTX 4090D。我们只有 8G,所以跑之前改了三处:
| 参数 | 默认 | 我们改成 | 原因 |
|---|---|---|---|
| width × height | 640 × 640 | 832 × 480 | 起始图是横版 16:9,方形会把画面裁掉 |
| enable_turbo_mode | false(关) | true(开) | 用 4 步加速 LoRA;官方表里不开要 536 秒,开了 97 秒 |
| duration | 5.0 | 不动 | 5 秒够看效果 |
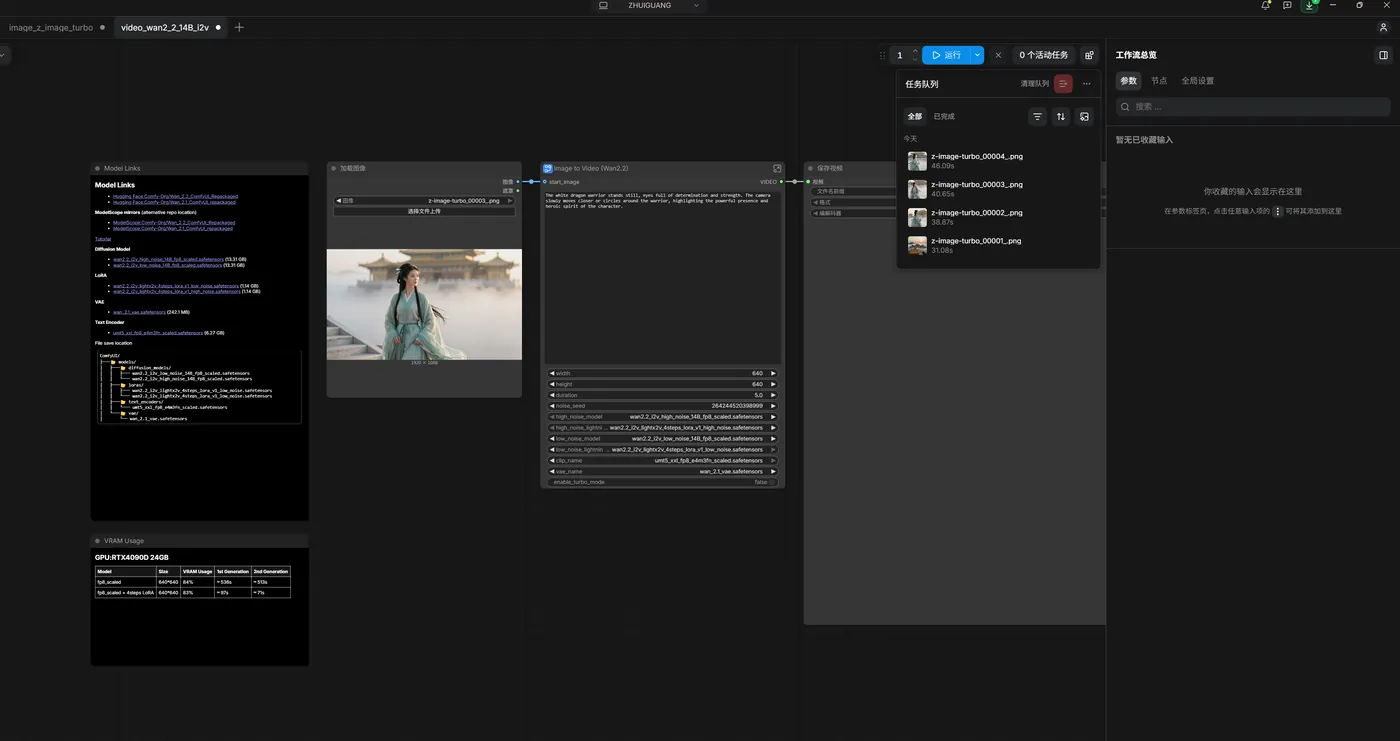
提示词只写动作:
结果:8G 显卡跑得动 14B 的模型,但要 560 秒,约 9 分 20 秒。同样开加速,官方 24G 显卡第一次是 97 秒,差了将近 6 倍(两边尺寸不完全一样,只能看量级)。原因是 30 多 GB 的模型放不进 8G 显存,ComfyUI 会自动把放不下的部分挪到内存里来回倒,时间大部分花在搬数据上。我们的内存是 64G,内存小的电脑会更慢。
画面本身没问题:转头、微笑、衣袖和云雾都在动,脸没有变形,也没有穿模。缺点是 Wan 2.2 只生成画面,没有声音,声音要后期自己加。
五、挑战:MiniMax H3 音画同步
MiniMax H3 是模板库里最新的视频模型,卖点是画面、对白、音效一次生成。它比 Wan 2.2 更大,官方没有说 8G 显卡能不能跑,所以这一段我们是抱着「跑不动也算一个结果」的心态试的。
选「MiniMax H3:图生视频」,提示「发现 5 个问题」,下载约 40GB。模板用的已经是省显存的版本:主模型是精简过的 INT8 版,文字模型是 NVFP4 版,另外还有视频 VAE、音频 VAE 和一个 8 步加速 LoRA。
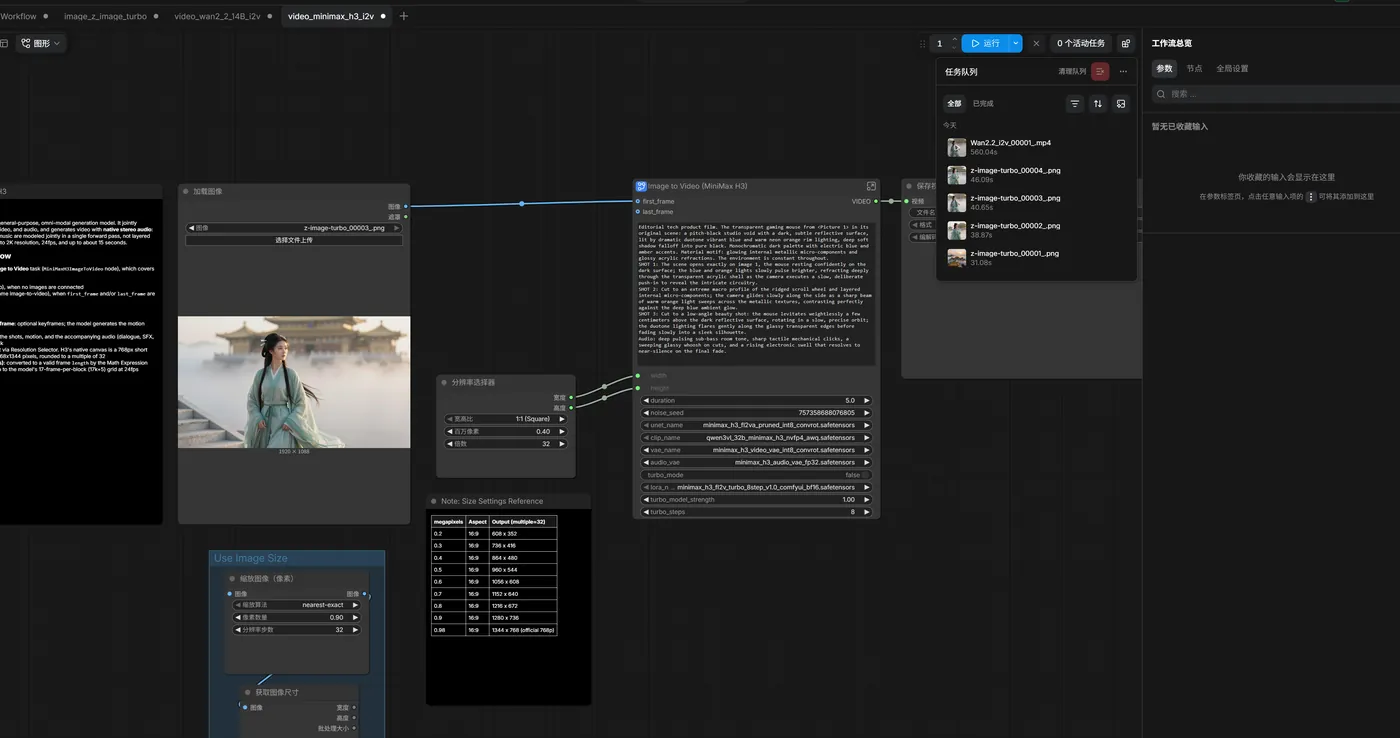
第一次只求跑通,设置尽量保守:
- 宽高比:1:1 改成 16:9;
- 百万像素:0.4 改成 0.3(736×416);
- turbo_mode:打开(8 步);
- duration:5 秒;
- 提示词里除了动作,还写了一句台词和想要的声音,大意如下。
结果出乎意料:153 秒就生成完了,比 Wan 2.2 的 560 秒还快,而且人物真的开口说了这句话,嘴型和声音对得上。0.3 百万像素看着偏糊,于是把百万像素调高再跑一次,出来是 1216×672,清晰度好了很多,就是本文开头那一段。
要说明两点。第一,跑高分辨率这一次的时候,鼠标拖动界面已经明显卡顿,我们认为这差不多是 8G 显卡的上限,这一次的用时也没有记下来。第二,我们的内存是 64G,模型放不进显存的部分全靠内存撑着;内存只有 16G 或 32G 的电脑,结果可能不一样。
六、踩过的坑
| 现象 | 原因和处理 |
|---|---|
| 模板一打开就是红框,提示「发现 N 个问题」 | 缺模型,不是坏了。点「查看详情」→「全部下载」,下完点刷新 |
| 模板右上角有小皇冠 | 这是付费的云端模型(比如 Seedance、Nano Banana),运行要扣积分。想免费就选不带皇冠的 |
| 磁盘很快就满了 | 三套模型将近 95GB。安装目录别放 C 盘,不用的模型及时清 |
| 视频慢得离谱 | 先看加速开关(turbo)开了没有。Wan 2.2 不开加速,官方 24G 显卡都要 500 多秒 |
| 点了运行以后改参数,结果没变化 | 正在跑的任务用的是点运行那一刻的参数。改完要重新点运行 |
| 连点了两次运行 | 第二次会排队,跑完第一个接着跑第二个。视频一个就要几分钟,记得在任务队列里把多余的删掉 |
| 图生视频的画面被裁掉一块 | 模板默认是方形。横版图要把宽高改成 16:9 的尺寸 |
七、开源和闭源怎么选
| 开源(ComfyUI 本地跑) | 闭源(网页或 API 付费) | |
|---|---|---|
| 花费 | 不花积分,只花电费和硬盘 | 按次扣积分或按月付费 |
| 硬件 | 要好显卡,显存越大越快 | 不挑电脑 |
| 速度 | 8G 显卡出图几十秒,视频几分钟 | 通常更快 |
| 画质 | 受模型和显卡限制 | 通常更好、更稳定 |
| 可控性 | 每个参数都能调,还能加插件 | 平台给什么用什么 |
| 限制 | 要自己下模型、自己排查问题 | 有内容审核;平台调价或下架只能接受 |
打个比方:开源像买菜回家自己做饭,闭源像去饭店点菜。